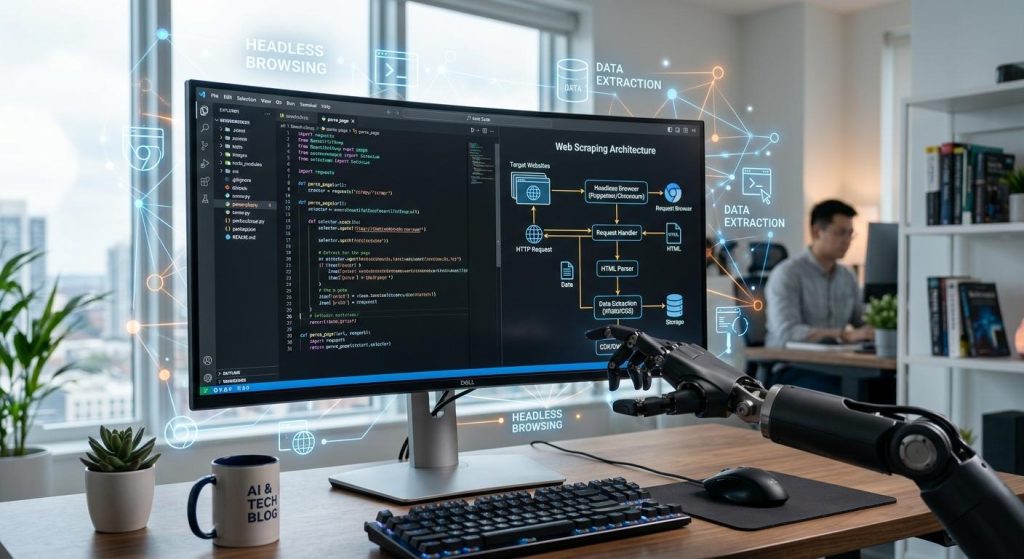
¿Sabías que es posible extraer datos web sin necesidad de abrir un navegador gráfico? OpenClaw es un navegador headless diseñado para scraping eficiente, eliminando la carga y complejidad de interfaces visuales. Esto significa menos recursos usados y mayor velocidad en la automatización de tareas web, ideal para desarrolladores que buscan soluciones robustas y ligeras.
Si alguna vez te has frustrado con la lentitud o la sobrecarga de navegadores tradicionales en tus proyectos de scraping, OpenClaw ofrece una alternativa práctica y directa. En este artículo, te mostraré cómo configurarlo paso a paso, explicaré sus ventajas y también sus limitaciones reales, para que puedas tomar decisiones informadas. Desde conceptos básicos hasta ejemplos claros, encontrarás todo lo necesario para integrar esta herramienta en tus flujos de trabajo, ya seas principiante o un desarrollador con experiencia. Prepárate para optimizar tu extracción de datos con un enfoque práctico y sin complicaciones innecesarias.
Qué es OpenClaw y cómo funciona sin navegador
OpenClaw es una herramienta de scraping diseñada para extraer datos web sin necesidad de utilizar un navegador tradicional, ni siquiera uno headless. A diferencia de los enfoques convencionales que dependen de navegadores como Chrome o Firefox en modo invisible, OpenClaw opera mediante agentes autónomos que interactúan con las páginas web a nivel de red y contenido, evitando la sobrecarga y complejidad que implica manejar sesiones, cookies o perfiles de navegador. Esto lo hace especialmente eficiente para proyectos que requieren escalabilidad y ejecución en entornos con recursos limitados, como servidores VPS pequeños o sistemas distribuidos.
Su funcionamiento se basa en el uso de APIs inteligentes y motores de extracción que interpretan y procesan el contenido HTML, JSON o incluso datos renderizados por JavaScript, sin cargar una interfaz gráfica ni ejecutar un motor de navegador completo. Por ejemplo, OpenClaw puede integrarse con servicios como Firecrawl o Decodo, que proporcionan renderizado de JavaScript y evasión de bots, para obtener contenido dinámico y estructurado, listo para ser consumido por modelos de lenguaje o sistemas de análisis [[1]](https://lumadock.com/tutorials/web-scraping-with-openclaw), [[2]](https://medium.com/@info.booststash/how-to-use-firecrawl-with-openclaw-for-advanced-web-scraping-00de1c637216), [[5]](https://decodo.com/blog/decodo-openclaw-integration).
- Agentes autónomos: OpenClaw utiliza agentes que pueden ejecutar comandos de scraping sin abrir un navegador, lo que reduce el consumo de memoria y CPU.
- Extracción limpia: Convierte el contenido web en formatos legibles y estructurados, como markdown o JSON, facilitando su procesamiento automático.
- Integración con APIs de renderizado: Permite manejar contenido dinámico y JavaScript sin necesidad de un navegador, gracias a la conexión con APIs especializadas.
Este enfoque no solo simplifica la arquitectura de scraping, sino que también mejora la estabilidad y velocidad de los procesos, evitando problemas comunes como bloqueos por detección de bots o errores en el renderizado. Sin embargo, es importante considerar que, al no usar un navegador real, algunas interacciones muy complejas o específicas pueden requerir ajustes o el uso combinado con otras herramientas. En resumen, OpenClaw ofrece una alternativa moderna y ligera para scraping headless, ideal para desarrolladores que buscan eficiencia y flexibilidad sin la carga de un navegador tradicional.
Ventajas clave del scraping headless con OpenClaw
Extraer datos sin la necesidad de cargar un navegador completo es un cambio de juego para cualquier proyecto de scraping que busque eficiencia y escalabilidad. OpenClaw elimina la pesada carga que implica manejar sesiones, cookies y perfiles de navegador, lo que se traduce en un consumo mucho más bajo de recursos, ideal para entornos con limitaciones como VPS pequeños o infraestructuras distribuidas. Este enfoque headless, pero sin navegador, acelera los procesos y reduce fallos comunes asociados a bloqueos por detección de bots o errores de renderizado.
- Reducción significativa del consumo de recursos: Al no abrir un navegador real, OpenClaw usa agentes autónomos que interactúan directamente con el contenido web, lo que implica menos uso de CPU y memoria. Esto permite ejecutar más tareas simultáneamente sin saturar el servidor.
- Extracción precisa y estructurada: Convierte el contenido en formatos limpios y fáciles de procesar como JSON o Markdown, simplificando la integración con sistemas de análisis o modelos de lenguaje, y evitando la necesidad de limpieza manual posterior.
- Manejo efectivo de contenido dinámico: Gracias a su integración con APIs especializadas para renderizado de JavaScript, OpenClaw puede acceder a datos que tradicionalmente requerirían un navegador completo, manteniendo la ligereza y velocidad del proceso.
- Menor riesgo de ser bloqueado: Al no simular un navegador tradicional, el tráfico generado por OpenClaw es menos detectable como bot convencional, lo que mejora la tasa de éxito en sitios con protección anti-scraping.
Ejemplo práctico: scraping para ecommerce
En un proyecto típico de monitoreo de precios, OpenClaw puede configurarse para visitar páginas de productos, extraer información actualizada y comparar datos con una base almacenada, todo sin abrir un navegador. Esto permite alertas en tiempo real sin la latencia ni el overhead de un navegador headless tradicional, facilitando la automatización continua y escalable [[1]](https://www.tencentcloud.com/techpedia/140765).
Consejos para aprovechar al máximo OpenClaw
- Configura agentes específicos para cada tipo de tarea para optimizar recursos y evitar cuellos de botella.
- Combina OpenClaw con servicios de renderizado externos para sitios con JavaScript complejo.
- Usa formatos estructurados para facilitar la integración con sistemas downstream y evitar procesamiento adicional.
Este enfoque no solo es más rápido y eficiente, sino que también simplifica la arquitectura de scraping, haciendo que la automatización sea más robusta y fácil de mantener en el tiempo. Sin duda, OpenClaw representa una evolución práctica para desarrolladores que necesitan resultados fiables sin complicaciones técnicas innecesarias.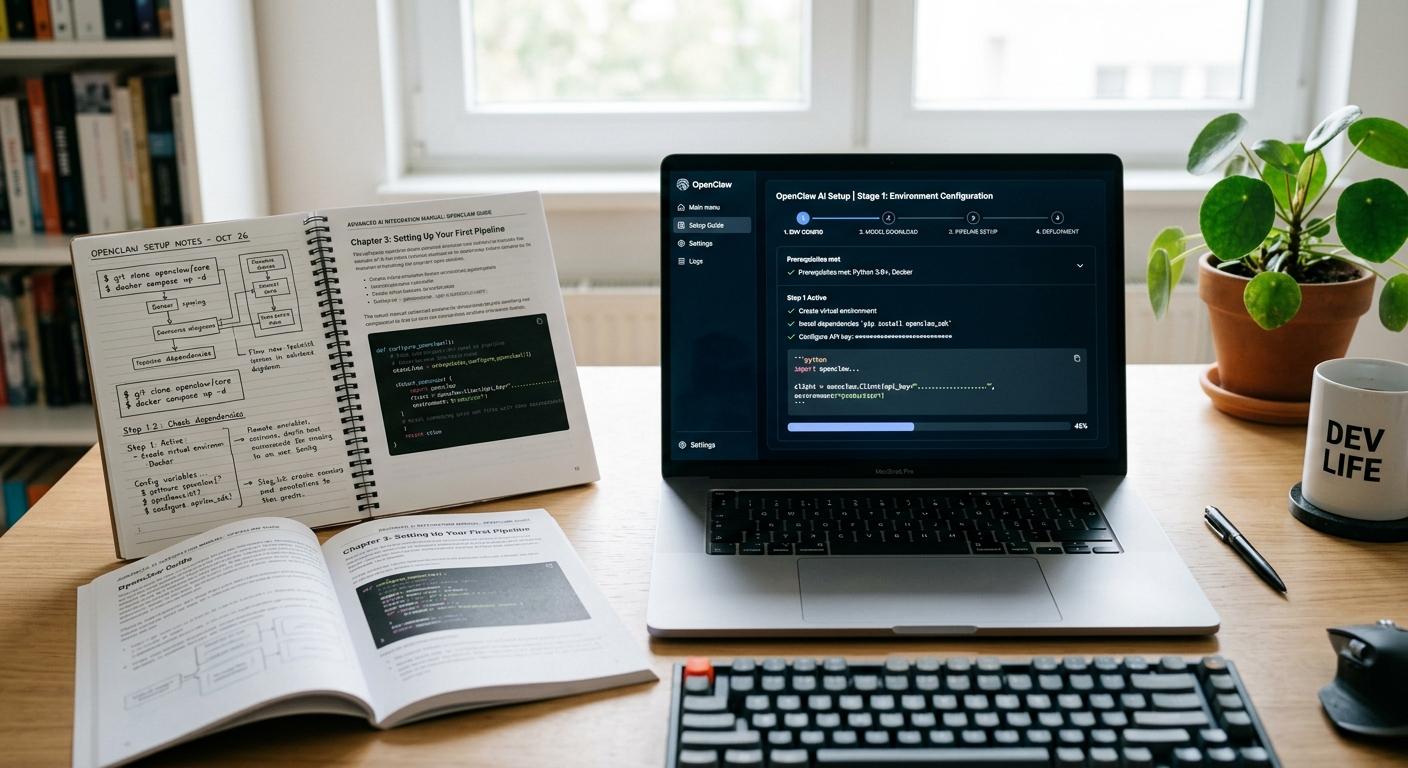
Guía paso a paso para configurar OpenClaw desde cero
Configurar OpenClaw desde cero puede parecer intimidante al principio, pero con una guía clara y práctica, cualquier persona con conocimientos básicos en línea de comandos y algo de experiencia técnica puede tener su agente de scraping funcionando en poco tiempo. Lo que hace especial a OpenClaw es su enfoque ligero y autónomo: no depende de un navegador tradicional, sino que usa agentes que interactúan directamente con el contenido web, lo que optimiza recursos y simplifica la arquitectura.
Para empezar, lo primero es preparar el entorno. OpenClaw se instala preferentemente en sistemas Linux o VPS, aunque también funciona en Windows con ciertas adaptaciones. Usar un VPS pequeño es suficiente para proyectos medianos, gracias a su bajo consumo. El repositorio oficial está disponible en GitHub, y la instalación básica se realiza clonando el repositorio y configurando las dependencias con comandos estándar como `pip` para Python o `npm` para Node.js, según la versión que uses.
- Clonar el repositorio: `git clone https://github.com/openclaw/openclaw.git`
- Instalar dependencias: Navega a la carpeta y ejecuta `pip install -r requirements.txt` o el equivalente para tu entorno.
- Configurar credenciales y permisos: OpenClaw necesita acceso para leer y escribir archivos, ejecutar scripts y conectarse a APIs. Ajusta permisos en el sistema y configura variables de entorno para tokens o claves API si es necesario.
Una vez instalado, el siguiente paso clave es definir los agentes. Piensa en un agente como un mini-programa especializado que sabe qué datos extraer y cómo hacerlo. OpenClaw permite crear agentes personalizados mediante archivos de configuración en formato YAML o JSON, donde especificas URLs objetivo, selectores CSS o XPath para extraer datos, y reglas para manejar paginación o contenido dinámico. Por ejemplo, para un scraping de productos en ecommerce, definirás un agente que visite cada página de producto, extraiga título, precio y disponibilidad, y guarde la información en JSON.
Ejemplo básico de configuración de agente (YAML):
“`yaml
agent_name: producto_scraper
start_urls:
– https://ejemplo-ecommerce.com/categoria/productos
selectors:
titulo: ‘h1.product-title’
precio: ‘.price-tag’
disponibilidad: ‘.stock-status’
output_format: json
“`
Después, para lanzar el agente, usarás comandos en terminal que inicien la ejecución y supervisen el proceso. OpenClaw ofrece logs detallados para entender qué está pasando en cada paso, facilitando la detección de errores o bloqueos. Si el sitio web usa JavaScript para cargar contenido, se recomienda integrar OpenClaw con servicios externos de renderizado o APIs especializadas para manejar ese contenido dinámico sin abrir un navegador completo.
Consejos prácticos para una configuración exitosa
- Divide y vencerás: Crea agentes específicos para cada tipo de tarea o sitio web, evita agentes genéricos que compliquen el mantenimiento.
- Prueba local antes de escalar: Ejecuta agentes en tu máquina local para validar configuraciones y corregir errores antes de desplegar en servidores.
- Automatiza con orquestadores: Usa herramientas de orquestación para programar ejecuciones periódicas, manejar errores y combinar resultados.
- Documenta tu configuración: Mantén archivos de configuración claros y comenta cada sección para facilitar futuras modificaciones o colaboraciones.
Con estos pasos y recomendaciones, tendrás un entorno OpenClaw funcional, listo para extraer datos sin la sobrecarga de un navegador tradicional. La clave está en entender bien cada componente: agentes, configuración, permisos y ejecución, para aprovechar al máximo la potencia y eficiencia que ofrece esta herramienta headless sin navegador.
Cómo manejar JavaScript y contenido dinámico sin navegador
El mayor reto al extraer datos de sitios modernos es que gran parte del contenido se genera o modifica dinámicamente mediante JavaScript, lo que dificulta obtener información solo con solicitudes HTTP tradicionales. OpenClaw aborda este desafío sin depender de un navegador completo, utilizando agentes especializados que interpretan y ejecutan scripts JavaScript de forma selectiva para acceder a los datos finales que se muestran al usuario. Esto reduce la carga de recursos y acelera el proceso en comparación con soluciones headless basadas en navegadores como Chrome o Firefox.
Para manejar contenido dinámico, OpenClaw permite configurar agentes que simulan la ejecución de JavaScript en un entorno controlado. Estos agentes pueden interceptar llamadas AJAX, analizar respuestas JSON y reconstruir el DOM virtual para extraer los datos visibles sin renderizar toda la página. Además, se pueden integrar con servicios externos de renderizado ligero o APIs que procesan JavaScript en la nube, devolviendo contenido ya evaluado. Así, se evita la sobrecarga de abrir un navegador real y se mantiene la eficiencia, especialmente útil en VPS o sistemas con recursos limitados.
- Interceptación de peticiones: Los agentes detectan y capturan llamadas a APIs internas del sitio, accediendo directamente a datos estructurados.
- Evaluación selectiva de scripts: Ejecutan solo los fragmentos JavaScript necesarios para cargar contenido dinámico, sin procesar toda la lógica del navegador.
- Uso de proxies de renderizado: Cuando la complejidad de JavaScript es alta, OpenClaw se conecta con servicios que devuelven HTML ya procesado para extraer información fácilmente.
Un ejemplo práctico es un ecommerce donde los precios y stock se actualizan tras cargar la página con JavaScript. En lugar de esperar a que un navegador renderice todo, un agente OpenClaw puede identificar las URLs de las APIs internas que devuelven esos datos en JSON, hacer las solicitudes directamente y parsear la respuesta. Así se obtiene la información en segundos, evitando bloqueos y consumo excesivo de CPU o memoria.
Consejos para manejar JavaScript sin navegador
- Analiza el tráfico de red: Usa herramientas como DevTools para identificar endpoints AJAX que puedes consultar directamente.
- Define selectores precisos: Al extraer contenido dinámico, usa selectores CSS o XPath que funcionen con el DOM final generado por el agente.
- Implementa tiempos de espera inteligentes: Espera eventos o respuestas específicas antes de extraer datos para evitar capturar contenido incompleto.
- Combina agentes y servicios externos: Usa renderizadores headless en la nube solo para páginas con JavaScript muy complejo, manteniendo ligereza localmente.
Aunque OpenClaw no ejecuta un navegador completo, su enfoque híbrido y modular permite manejar la mayoría de los casos prácticos de contenido dinámico con eficacia. Esto lo convierte en una opción sólida para proyectos que requieren scraping rápido, escalable y con bajo consumo, sin renunciar a la capacidad de procesar JavaScript cuando es necesario.
Integración de OpenClaw con APIs y flujos de trabajo automatizados
La verdadera potencia de OpenClaw no solo reside en su capacidad para extraer datos sin un navegador tradicional, sino en cómo se integra de forma fluida con APIs y sistemas de automatización para crear flujos de trabajo robustos y eficientes. En lugar de limitarse a obtener información, OpenClaw puede actuar como un nodo dentro de una cadena automatizada que conecta múltiples servicios, desde bases de datos hasta plataformas de mensajería o CRMs, lo que multiplica su utilidad en proyectos reales.
OpenClaw trabaja mediante agentes configurables que pueden consumir APIs internas o externas, procesar respuestas JSON o XML, y disparar acciones en función del contenido extraído. Por ejemplo, un agente puede consultar periódicamente una API de precios, comparar resultados con un umbral definido y enviar alertas vía Telegram o WhatsApp automáticamente. Esta capacidad de orquestación convierte a OpenClaw en un intermediario inteligente que no solo scrapea, sino que también interactúa con otros sistemas sin intervención manual.
- Conexión directa con APIs: OpenClaw permite definir endpoints REST o GraphQL para realizar peticiones sincronizadas o asíncronas, facilitando la extracción de datos estructurados sin necesidad de interpretar HTML.
- Automatización basada en eventos: Los agentes pueden configurarse para reaccionar a triggers específicos, como cambios en datos, horarios o respuestas condicionadas, integrándose con plataformas como Zapier o Integromat para ampliar el ecosistema.
- Orquestación de tareas complejas: Se pueden encadenar múltiples agentes que ejecutan pasos consecutivos -desde scraping, procesamiento, filtrado, hasta notificación- creando pipelines personalizados adaptados a cada caso de uso.
Ejemplo práctico de integración
Imagina un flujo donde OpenClaw extrae datos de stock de un ecommerce a través de su API interna. Al detectar una baja en inventario, el agente envía automáticamente una solicitud a un sistema ERP para reabastecimiento y notifica al equipo de ventas vía Slack. Todo esto ocurre sin intervención humana y con una latencia mínima, gracias a la comunicación directa entre APIs y la capacidad de OpenClaw para gestionar múltiples tareas en paralelo.
Para configurar estas integraciones, es clave entender cómo funcionan los agentes y su lenguaje de configuración, que suele ser JSON o YAML, donde defines endpoints, headers, intervalos de ejecución y acciones posteriores. También es recomendable usar herramientas de monitoreo para verificar el estado de cada agente y detectar fallos o retrasos en las llamadas API.
Consejos para optimizar flujos automatizados
- Gestiona la autenticación: Muchas APIs requieren tokens o claves. OpenClaw permite almacenar credenciales de forma segura y renovarlas automáticamente si es necesario.
- Maneja errores y reintentos: Configura políticas para reintentar solicitudes fallidas y alertar cuando se superen ciertos límites, evitando que un fallo detenga todo el flujo.
- Usa caché local: Para evitar llamadas repetidas y mejorar rendimiento, los agentes pueden almacenar respuestas temporalmente y decidir cuándo refrescarlas.
- Documenta tus flujos: Mantén un registro claro de cada agente, su función y dependencias para facilitar mantenimiento y escalabilidad.
En resumen, integrar OpenClaw con APIs y flujos automatizados no solo amplía el alcance del scraping headless, sino que transforma tu sistema en un entorno inteligente capaz de reaccionar y adaptarse a datos en tiempo real, con un control total y sin depender de servicios externos. Esta flexibilidad es clave para proyectos que buscan eficiencia, escalabilidad y autonomía en la gestión de datos.
Solución de problemas comunes y optimización de rendimiento
Cuando un proyecto de scraping con OpenClaw no funciona como esperas, la causa suele estar en detalles de configuración o en la gestión del entorno, no en la herramienta misma. OpenClaw es potente, pero como cualquier sistema automatizado, requiere ajustes finos para maximizar rendimiento y evitar fallos recurrentes. Por ejemplo, un error típico es no contemplar adecuadamente los tiempos de espera en respuestas API o el manejo de datos dinámicos, lo que puede llevar a resultados incompletos o agentes bloqueados.
Para evitar estos problemas, lo primero es implementar una estrategia robusta de manejo de errores. Configura tus agentes para que reconozcan fallos temporales y reintenten automáticamente, con límites claros para no caer en bucles infinitos. OpenClaw permite definir políticas de reintentos y alertas, que son clave para mantener la continuidad sin intervención manual. Además, monitorear logs y estados de agentes con herramientas externas o integradas te dará visibilidad en tiempo real y facilitará la identificación rápida de cuellos de botella o caídas inesperadas.
- Controla los tiempos de ejecución: Ajusta los intervalos de scraping y los timeouts para evitar saturar tanto tu infraestructura como los servidores destino.
- Cachea resultados temporalmente: Implementa almacenamiento local para respuestas frecuentes y reduce llamadas innecesarias, mejorando la velocidad y disminuyendo la carga.
- Valida y limpia datos: Usa filtros y reglas en los agentes para detectar datos corruptos o inconsistentes antes de almacenarlos o enviarlos a otros sistemas.
Otro punto crítico es la gestión del contenido dinámico y JavaScript, que puede ser un desafío sin navegador tradicional. OpenClaw no ejecuta código JS de forma nativa, por lo que para páginas altamente dinámicas es recomendable combinarlo con servicios externos de renderizado o APIs especializadas que extraigan el HTML ya procesado. Esto evita bloqueos y acelera el flujo, aunque añade complejidad, por lo que conviene evaluar caso por caso.
Optimización avanzada: orquestación y recursos
Cuando escalas tus agentes, la orquestación eficiente es vital. Divide tareas complejas en agentes especializados que se comuniquen mediante eventos o colas. Esto mejora la resiliencia y permite aislar fallos sin afectar todo el sistema. Además, configura límites de concurrencia para evitar picos de demanda que puedan saturar tu infraestructura self-hosted.
| Problema común | Solución práctica |
|---|---|
| Agente bloqueado por timeout | Aumentar timeout y configurar reintentos con backoff exponencial |
| Datos incompletos o erróneos | Implementar validación y limpieza en el flujo de datos |
| Consumo excesivo de recursos | Limitar concurrencia y usar caché para reducir llamadas |
| Fallas por contenido dinámico | Integrar servicios de renderizado externo para JS |
Por último, no subestimes la importancia de documentar cada agente, su configuración y dependencias. Esto facilita la detección de problemas y la optimización continua, especialmente en equipos donde varias personas trabajan sobre la misma infraestructura. Con estos consejos, podrás mantener tus flujos con OpenClaw estables, rápidos y adaptados a cualquier desafío real de scraping sin navegador.
Casos prácticos: scraping eficiente para ecommerce y datos públicos
En el mundo del ecommerce y la recopilación de datos públicos, la eficiencia y precisión en el scraping son clave para obtener información valiosa sin sobrecargar recursos ni infringir reglas. OpenClaw destaca por su capacidad para automatizar la extracción de datos de forma headless, es decir, sin depender de un navegador tradicional, lo que reduce significativamente el consumo de memoria y CPU, facilitando la ejecución en servidores modestos o entornos self-hosted.
Para ecommerce, por ejemplo, OpenClaw puede configurarse para monitorear precios, disponibilidad y reseñas de productos en múltiples sitios simultáneamente. Gracias a su integración con APIs de renderizado externo, como Decodo o Firecrawl, es posible obtener contenido dinámico generado por JavaScript sin abrir un navegador completo. Esto es crucial para sitios modernos que cargan datos vía AJAX o frameworks SPA. Un flujo típico incluye agentes especializados que consultan URLs específicas, aplican filtros para limpiar datos erróneos y almacenan resultados en bases estructuradas para análisis o alertas automáticas.
En cuanto a datos públicos, OpenClaw permite extraer información de portales gubernamentales, bases de datos abiertas y foros sin necesidad de interfaces visuales pesadas. Su arquitectura basada en agentes facilita la orquestación de tareas complejas, como la actualización periódica de datasets o la combinación de fuentes diversas para enriquecer análisis. La posibilidad de controlar proxies y definir políticas de reintentos hace que el scraping sea más robusto frente a bloqueos o limitaciones de acceso.
- Ejemplo práctico ecommerce: Un agente que rastrea diariamente un marketplace para detectar cambios en precios de productos clave, almacenando solo variaciones para optimizar espacio.
- Ejemplo práctico datos públicos: Un pipeline que extrae informes estadísticos de un portal oficial, convierte tablas HTML a JSON y los integra en un dashboard actualizado.
| Uso | Configuración clave | Beneficio principal |
|---|---|---|
| Monitoreo de precios | Agentes con proxies rotativos y filtros de validación | Actualizaciones rápidas y datos limpios para decisiones comerciales |
| Extracción de datos públicos | Orquestación de agentes y renderizado externo para JS | Acceso fiable a datos dinámicos sin sobrecargar infraestructura |
La clave para un scraping eficiente con OpenClaw en estos escenarios está en la correcta configuración de agentes, el manejo inteligente de proxies y la integración con APIs de renderizado para contenido dinámico. Además, implementar validaciones y cachés locales evita repetir solicitudes innecesarias y mejora la velocidad. Con estas prácticas, OpenClaw se convierte en una herramienta poderosa y flexible para proyectos reales de scraping en ecommerce y datos públicos, sin la complejidad ni el peso de navegadores headless tradicionales.
Comparativa: OpenClaw vs otros navegadores headless populares
En el universo del scraping web, elegir la herramienta adecuada puede marcar la diferencia entre un proyecto exitoso y uno lleno de cuellos de botella. OpenClaw se posiciona como una alternativa innovadora frente a los navegadores headless tradicionales como Puppeteer o Playwright, principalmente porque elimina la necesidad de ejecutar un navegador completo en segundo plano. Esto no solo reduce el consumo de recursos, sino que también simplifica la arquitectura, especialmente en entornos self-hosted o con limitaciones de hardware.
A diferencia de Puppeteer y Playwright, que controlan navegadores reales (Chromium, Firefox, WebKit) en modo headless para renderizar páginas y ejecutar JavaScript, OpenClaw se apoya en APIs de renderizado externo y agentes especializados para procesar contenido dinámico sin abrir ventanas ni procesos pesados. Esto significa que, aunque no “vea” la página como un navegador tradicional, puede manejar AJAX, SPAs y otros elementos dinámicos eficientemente, evitando el sobrecoste de memoria y CPU que suelen implicar estas herramientas [[2]](https://docs.firecrawl.dev/es/developer-guides/openclaw), [[6]](https://brightdata.es/blog/datos-web/puppeteer-vs-playwright).
Ventajas prácticas de OpenClaw frente a navegadores headless clásicos
- Ligereza y escalabilidad: Al no depender de un motor gráfico ni procesos de navegador completos, OpenClaw permite desplegar múltiples agentes en máquinas con recursos limitados, ideal para proyectos que requieren alta concurrencia o despliegues en la nube privada.
- Integración con IA y orquestación avanzada: OpenClaw destaca por su capacidad de integrar flujos con inteligencia artificial y sistemas de orquestación que automatizan tareas complejas, algo menos accesible en soluciones como Puppeteer, que se centran en la interacción directa con la página [[5]](https://help.apiyi.com/es/openclaw-browser-automation-guide-es.html).
- Manejo simplificado de proxies y reintentos: Su arquitectura basada en agentes facilita la gestión de proxies rotativos y políticas de reintentos, mejorando la resiliencia frente a bloqueos sin necesidad de intervenciones manuales frecuentes.
Limitaciones y casos donde Puppeteer o Playwright siguen siendo preferibles
Aunque OpenClaw es potente para la mayoría de escenarios, existen situaciones donde un navegador headless tradicional puede ser más adecuado:
- Interacción compleja con la UI: Si el proyecto requiere simular interacciones humanas muy específicas (clics, arrastres, formularios complejos), Puppeteer o Playwright ofrecen APIs más directas para controlar el navegador real.
- Depuración visual: Para desarrolladores que necesitan ver el proceso de scraping en acción, las herramientas headless con modo visible facilitan la identificación de problemas.
- Compatibilidad nativa con múltiples navegadores: Playwright, por ejemplo, soporta Chromium, Firefox y WebKit, mientras que OpenClaw depende del renderizado externo, lo que puede implicar diferencias en el comportamiento de la página.
| Característica | OpenClaw | Puppeteer / Playwright |
|---|---|---|
| Consumo de recursos | Bajo, no ejecuta navegador completo | Alto, ejecuta navegador en modo headless |
| Manejo de JavaScript dinámico | Mediante APIs de renderizado externo | Directo, en el navegador real |
| Configuración y orquestación | Agentes y flujos integrados, fácil escalabilidad | Requiere scripts y herramientas externas para orquestación |
| Interacción con UI | Limitada, más orientado a extracción | Completa, simula usuarios reales |
| Compatibilidad multi-navegador | Depende del servicio de renderizado | Alta, soporta varios motores |
En resumen, OpenClaw es una opción sobresaliente para proyectos que priorizan eficiencia, escalabilidad y manejo avanzado de datos dinámicos sin la complejidad de un navegador completo. Para tareas donde la interacción detallada con la interfaz o la depuración visual son críticas, Puppeteer o Playwright siguen siendo las herramientas de referencia. La elección debe basarse en las necesidades específicas del proyecto y los recursos disponibles, aprovechando las fortalezas de cada enfoque para maximizar resultados.
Seguridad y ética en scraping sin navegador con OpenClaw
La automatización del scraping sin navegador con OpenClaw abre muchas puertas, pero también plantea desafíos importantes en materia de seguridad y ética que no pueden pasarse por alto. Aunque eliminar la carga de un navegador completo reduce la superficie de ataque y el consumo de recursos, el scraping sigue siendo una actividad que debe ejecutarse con responsabilidad para evitar consecuencias legales y técnicas indeseadas.
Un punto clave es respetar las políticas de uso y términos de servicio de los sitios web objetivo. OpenClaw facilita la integración con proxies rotativos y agentes que imitan comportamientos humanos, lo que puede ayudar a evitar bloqueos, pero no justifica la extracción masiva o el acceso a datos sensibles sin permiso. Implementar límites en la frecuencia de peticiones y respetar el archivo robots.txt son prácticas básicas que protegen tanto al scraper como al servidor destino. Ignorar estas normas puede derivar en bloqueos permanentes o incluso acciones legales.
Buenas prácticas para minimizar riesgos
- Configuración ética de agentes: Ajusta los tiempos entre solicitudes para no saturar los servidores. OpenClaw permite configurar pausas y reintentos inteligentes para evitar picos de tráfico.
- Gestión segura de proxies: Usa proxies confiables y evita IPs públicas que puedan comprometer la privacidad o integridad de tus agentes.
- Filtrado de datos sensibles: Implementa validaciones para evitar almacenar información personal o confidencial que pueda vulnerar leyes de privacidad, como GDPR.
- Auditoría y monitoreo: Registra logs detallados de las actividades de scraping para detectar comportamientos anómalos o accesos indebidos.
Aspectos técnicos y legales a considerar
OpenClaw, al no usar un navegador real, depende de APIs externas para renderizar y extraer contenido, lo que puede complicar la trazabilidad y el control sobre los datos obtenidos. Por eso, es fundamental elegir proveedores confiables y transparentes que cumplan con normativas vigentes. Además, la automatización avanzada debe incluir mecanismos para detectar cambios en las páginas que puedan indicar bloqueos o actualizaciones que requieran ajustes en los agentes.
Legalmente, el scraping está en una zona gris que varía según jurisdicción y contexto. No todos los datos disponibles en la web son libres para ser extraídos y usados. Por ejemplo, sitios con contenido protegido por derechos de autor o bases de datos con restricciones requieren un análisis previo y, en muchos casos, autorización explícita. La ética en scraping implica también respetar la propiedad intelectual y el esfuerzo de los creadores de contenido.
Balance entre eficiencia y responsabilidad
El verdadero poder de OpenClaw radica en su capacidad de automatizar sin sobrecargar recursos, pero esa eficiencia debe ir acompañada de un compromiso ético y técnico. Implementar controles internos, como límites de uso, validación de datos y monitoreo continuo, no solo previene problemas legales y técnicos, sino que también mejora la calidad y sostenibilidad de los proyectos a largo plazo. En definitiva, usar OpenClaw con conciencia y respeto por el ecosistema web es la mejor manera de sacar provecho real sin poner en riesgo tu infraestructura o reputación.
Personalización avanzada: agentes, proxies y orquestación
Una de las mayores fortalezas de OpenClaw reside en su capacidad para personalizar agentes inteligentes que actúan como extensiones de tu lógica de scraping, combinados con una gestión avanzada de proxies y una orquestación precisa de tareas. Esto no solo mejora la eficiencia, sino que también permite adaptar el sistema a escenarios complejos donde el scraping debe ser robusto, sigiloso y escalable. En lugar de depender de un navegador completo, OpenClaw permite diseñar agentes que interactúan con APIs, manejan flujos de datos y ejecutan scripts específicos, todo bajo tu control directo.
Los agentes en OpenClaw pueden configurarse para simular comportamientos humanos, gestionar sesiones, manejar cookies y rotar entre diferentes identidades IP mediante proxies. Esta flexibilidad es clave para evitar bloqueos y maximizar la tasa de éxito en sitios con protecciones anti-scraping. Por ejemplo, puedes crear un agente que utilice un proxy rotativo con reglas para cambiar IP tras un número determinado de peticiones o tras detectar un bloqueo, mientras otro agente se encarga de procesar y validar la información extraída. Esta separación modular simplifica la depuración y mejora la resiliencia del sistema.
Configuración práctica de proxies y agentes
- Proxies rotativos: Usa proveedores confiables y configura en OpenClaw la rotación automática para evitar que un solo IP sea baneado. Puedes definir listas blancas y negras para optimizar el rendimiento.
- Agentes personalizados: Define scripts en lenguajes compatibles que manejen la lógica de navegación sin navegador, incluyendo manejo de tokens, autenticación y recuperación de datos dinámicos.
- Orquestación de tareas: Programa flujos de trabajo donde varios agentes se comuniquen o se activen secuencialmente, por ejemplo, un agente que recolecta URLs y otro que procesa cada página.
Ejemplo básico de configuración YAML para un agente con proxy rotativo
| Parámetro | Descripción | Ejemplo |
|---|---|---|
| agent_name | Identificador único del agente | scraper_ecommerce |
| proxy_pool | Lista de proxies para rotar | [“proxy1:port”, “proxy2:port”, “proxy3:port”] |
| retry_policy | Política para reintentos tras fallo | 3 intentos con espera exponencial |
| rate_limit | Límites de peticiones por minuto | 30 peticiones/minuto |
La orquestación en OpenClaw puede ir más allá de la simple ejecución secuencial. Integrar herramientas de gestión de flujos (como Airflow o n8n) con OpenClaw permite montar pipelines complejos que incluyan extracción, transformación, almacenamiento y notificaciones automáticas. Esto es especialmente útil en entornos empresariales donde el scraping forma parte de un proceso mayor, como la actualización de bases de datos o la alimentación de sistemas de inteligencia de negocio.
Finalmente, la personalización avanzada no está exenta de desafíos. Es fundamental monitorear continuamente el comportamiento de los agentes y proxies para detectar bloqueos o anomalías. Implementar logs detallados y alertas tempranas te ayudará a ajustar configuraciones y evitar interrupciones prolongadas. Además, recuerda que la ética y el cumplimiento legal deben guiar cualquier estrategia de scraping, incluso cuando la tecnología te permite ser muy sofisticado.
Con OpenClaw, no solo obtienes un scraper sin navegador, sino un ecosistema flexible que puedes moldear a tus necesidades específicas, desde pequeñas pruebas hasta despliegues a gran escala con múltiples agentes colaborando en paralelo.
Escalabilidad y despliegue en entornos self-hosted
Cuando decides llevar OpenClaw a producción, la escalabilidad y el despliegue en entornos self-hosted se vuelven aspectos críticos para mantener la estabilidad y eficiencia de tus agentes de scraping. OpenClaw, al ser un agente de IA autoalojado, te da el control total sobre la infraestructura, pero también te pone la responsabilidad de gestionar recursos, seguridad y disponibilidad. Escalar no significa solo añadir más máquinas; es diseñar un sistema que pueda crecer de forma ordenada, respondiendo a la demanda sin perder rendimiento ni fiabilidad.
Para empezar, es fundamental separar los componentes: agentes de scraping, gestión de proxies, almacenamiento de datos y la orquestación de tareas. Esto permite distribuir la carga y aislar fallos. Por ejemplo, puedes desplegar varios agentes en contenedores Docker sobre un clúster Kubernetes o en VPS dedicados, cada uno con su configuración de proxy rotativo y límites de tasa personalizados. Así, si un agente falla o es bloqueado, los demás siguen operando sin interrupciones. Además, usar un sistema de colas (RabbitMQ, Redis) para distribuir las tareas entre agentes mejora la eficiencia y evita cuellos de botella.
Configuración recomendada para despliegues escalables
- Contenedores y orquestadores: Docker + Kubernetes o Docker Swarm te permiten escalar horizontalmente con facilidad, reiniciando agentes caídos automáticamente y balanceando la carga.
- Monitoreo y alertas: Implementa métricas (CPU, memoria, tasa de errores) con Prometheus y alertas vía Grafana o similar para detectar bloqueos o caídas de agentes a tiempo.
- Gestión centralizada de proxies: Usa un pool de proxies gestionado externamente o un proxy rotativo interno para evitar sobrecargar un solo IP y distribuir la carga de manera uniforme.
- Persistencia y backups: Asegura que los datos extraídos se almacenen en bases de datos o sistemas de archivos replicados, con backups automáticos para evitar pérdidas.
| Elemento | Función | Ejemplo |
|---|---|---|
| Agentes OpenClaw | Ejecutan scraping y lógica personalizada | Contenedores Docker con configuración YAML específica |
| Orquestador | Distribuye tareas y gestiona estados | Kubernetes + RabbitMQ |
| Proxy Pool | Rotación y gestión de IPs para evitar bloqueos | Servicio externo o proxy interno configurado en OpenClaw |
| Almacenamiento | Guarda datos y logs | Base de datos SQL/NoSQL + sistema de archivos con replicación |
Un aspecto que a menudo se subestima es la importancia de la orquestación inteligente. OpenClaw puede integrarse con herramientas como Airflow o n8n para crear pipelines que no solo ejecutan scraping, sino que también transforman, validan y notifican resultados automáticamente. Esto es clave para proyectos de gran escala donde la automatización total reduce errores manuales y acelera la entrega de datos útiles.
Por último, la infraestructura self-hosted implica un compromiso con la seguridad y el mantenimiento. Es vital mantener actualizados los sistemas operativos, restringir accesos con firewalls y VPNs, y cifrar comunicaciones entre agentes y servidores. La escalabilidad no solo es cuestión de añadir recursos, sino también de mantener un entorno controlado y confiable que garantice la continuidad del scraping sin sorpresas desagradables.
Con esta base, cualquier proyecto que utilice OpenClaw puede crecer desde un entorno de pruebas hasta una plataforma robusta capaz de manejar cientos de agentes y millones de peticiones, todo bajo tu control y sin depender de servicios externos cerrados.
Futuro del scraping headless y nuevas tendencias en automatización
La automatización del scraping headless está en plena transformación gracias a avances concretos en inteligencia artificial y arquitecturas distribuidas. OpenClaw no solo representa un agente autónomo capaz de ejecutar scraping sin navegador, sino que abre la puerta a un ecosistema donde la integración con flujos inteligentes y la orquestación avanzada serán la norma. Esto significa que el futuro no es solo extraer datos, sino hacerlo de manera más eficiente, adaptable y segura, con agentes que aprenden a reaccionar a bloqueos, cambios en sitios web y limitaciones de acceso sin intervención humana constante.
Un aspecto clave que ya está tomando fuerza es la combinación de scraping con técnicas de RAG (Retrieval-Augmented Generation), donde los datos extraídos se usan para alimentar modelos de lenguaje que generan insights, resúmenes o respuestas automáticas. Esto convierte a OpenClaw en una pieza central no solo para recolectar información, sino para crear valor inmediato, integrándose con sistemas de BI, chatbots o asistentes digitales. La capacidad de desplegar agentes en segundos y conectarlos a pipelines con herramientas como Airflow o n8n facilita que cualquier equipo pueda montar flujos completos de trabajo automatizados sin depender de software propietario ni infraestructuras complejas.
Tendencias que marcan el camino
- Agentes autónomos y adaptativos: OpenClaw y similares evolucionan para detectar cambios en las páginas, ajustar selectores y manejar captchas de forma automática, reduciendo la necesidad de mantenimiento manual.
- Integración nativa con APIs y servicios cloud: Más allá del scraping tradicional, la tendencia es combinar datos web con APIs oficiales o bases de datos públicas para enriquecer la información y validar resultados.
- Orquestación inteligente y escalabilidad automática: Los sistemas gestionarán la carga y redistribuirán tareas en función de la demanda y disponibilidad, usando contenedores y colas para evitar cuellos de botella.
- Seguridad y ética incorporadas desde el diseño: La automatización responsable incluye límites en la frecuencia de peticiones, anonimato mediante proxies rotativos y cumplimiento de términos legales para evitar sanciones.
Consejos prácticos para prepararte
- Invierte en modularidad: Diseña tus agentes y pipelines pensando en la reutilización y fácil actualización, anticipando cambios en los sitios objetivo.
- Monitorea constantemente: Usa métricas y alertas para detectar bloqueos o caídas y responde rápido con reinicios o ajustes automáticos.
- Experimenta con IA integrada: Prueba combinar OpenClaw con modelos de lenguaje para filtrar, clasificar o resumir datos en tiempo real.
- Documenta y automatiza todo: Desde la configuración de proxies hasta la gestión de errores, la documentación clara y los scripts de automatización son tu mejor aliado para escalar sin dolores de cabeza.
El scraping sin navegador está dejando de ser una tarea aislada para convertirse en un componente clave dentro de ecosistemas de datos inteligentes y autónomos. OpenClaw, con su enfoque open source y autoalojado, permite a desarrolladores y equipos mantener el control total mientras aprovechan las nuevas tendencias en automatización. Adaptarse a estos cambios no es solo cuestión de tecnología, sino de mentalidad: pensar en scraping como un flujo continuo, adaptable y responsable que aporta valor real y sostenible.
Preguntas Frecuentes
Q: ¿Cómo afecta el scraping sin navegador de OpenClaw a la velocidad y eficiencia del proceso?
A: El scraping sin navegador con OpenClaw mejora significativamente la velocidad y eficiencia al evitar la carga completa de interfaces gráficas. Esto reduce el consumo de recursos y acelera la extracción de datos, ideal para proyectos que requieren alta escalabilidad y rendimiento. Descubre más en la sección de *optimización de rendimiento*.
Q: ¿Qué tipos de contenido dinámico puede manejar OpenClaw sin un navegador tradicional?
A: OpenClaw puede procesar contenido dinámico generado por JavaScript y APIs directamente, sin necesidad de renderizar páginas completas. Usa agentes especializados para ejecutar scripts y capturar datos en tiempo real, facilitando el scraping de sitios modernos sin navegador. Consulta la guía sobre *manejo de JavaScript y contenido dinámico* para detalles.
Q: ¿Cuáles son las mejores prácticas para integrar proxies en OpenClaw y evitar bloqueos?
A: Para evitar bloqueos, integra proxies rotativos y configuraciones personalizadas en OpenClaw, usando agentes que alternan IPs automáticamente. Esto mejora la anonimización y reduce riesgos de detección. Revisa la sección de *personalización avanzada con proxies* para implementar esta estrategia eficazmente.
Q: ¿OpenClaw permite automatizar tareas web además del scraping? ¿Cómo?
A: Sí, OpenClaw automatiza tareas web como el llenado de formularios y navegación programada mediante secuencias de comandos headless. Esto facilita flujos de trabajo repetitivos sin interfaz gráfica, optimizando procesos automatizados. Más información en la parte de *automatización y flujos de trabajo integrados*.
Q: ¿Qué limitaciones técnicas tiene OpenClaw al trabajar sin navegador y cómo superarlas?
A: Las limitaciones incluyen dificultad para renderizar contenido muy complejo o interactivo. Se superan usando agentes especializados, proxies y orquestación avanzada para simular interacciones. Consulta *solución de problemas comunes* para técnicas y configuraciones prácticas que mejoran la robustez.
Q: ¿Cómo se puede escalar OpenClaw en entornos self-hosted para grandes volúmenes de datos?
A: Para escalar en self-hosted, distribuye agentes OpenClaw en múltiples servidores, usa balanceo de carga y orquestación de tareas. Esto permite manejar grandes volúmenes de scraping con estabilidad y control total. Explora la sección de *escalabilidad y despliegue* para una guía paso a paso.
Q: ¿Por qué OpenClaw es una opción ética para scraping sin navegador frente a otros métodos?
A: OpenClaw fomenta prácticas éticas al facilitar configuraciones que respetan límites de acceso y evitan sobrecargar servidores. Su diseño promueve transparencia y control, alineándose con normativas y buenas prácticas en scraping. Más detalles en *seguridad y ética en scraping*.
Q: ¿Cómo se personalizan los agentes en OpenClaw para tareas específicas de scraping sin navegador?
A: Los agentes en OpenClaw se personalizan mediante scripts y configuraciones que definen comportamiento, manejo de proxies y respuestas a eventos. Esto permite adaptar el scraping a necesidades específicas sin interfaz gráfica. Consulta *personalización avanzada* para ejemplos y configuraciones recomendadas.
—
Para profundizar en estas respuestas y optimizar tu uso de OpenClaw Headless Browser, revisa las secciones relacionadas de nuestro artículo. ¡Sigue explorando para dominar el scraping sin navegador con eficacia y ética!
Puntos clave
Ahora que conoces cómo OpenClaw Headless Browser facilita el scraping sin necesidad de un navegador tradicional, estás listo para optimizar tus procesos de extracción de datos con eficiencia y precisión. Esta herramienta ligera y configurable no solo reduce la carga en tus recursos, sino que también simplifica la automatización, permitiéndote enfocarte en análisis y resultados reales. Si aún tienes dudas sobre la integración o configuración, recuerda que dominar conceptos como agentes, orquestación y despliegue self-hosted es clave para sacarle el máximo provecho.
Para seguir profundizando, te invitamos a explorar nuestros artículos sobre Automatización avanzada con agentes inteligentes y Configuración paso a paso de entornos headless para scraping, donde encontrarás guías prácticas y ejemplos reales. No dejes pasar la oportunidad de suscribirte a nuestro boletín para recibir actualizaciones, trucos y casos de uso que te ayudarán a mantenerte a la vanguardia en scraping sin navegador. ¿Tienes preguntas o experiencias con OpenClaw? Déjanos un comentario y comparte tu opinión con la comunidad. Así, juntos, seguiremos construyendo soluciones efectivas y reales para la extracción de datos automatizada.
Recibe nuestras últimas guías, noticias y análisis destacados en la Búsqueda de Google y en AI Overviews.