¿Sabías que integrar Groq con OpenClaw puede acelerar significativamente las respuestas de tus agentes de inteligencia artificial? OpenClaw Groq combina la potencia de hardware especializado con modelos optimizados para ofrecer inferencias ultrarrápidas, mejorando la experiencia sin sacrificar precisión. Si buscas optimizar tus flujos de trabajo de automatización con un enfoque práctico y directo, esta guía en 5 pasos te mostrará cómo configurarlo y sacarle el máximo provecho.
En este artículo, desglosaremos el proceso para conectar OpenClaw con Groq, explicando desde la obtención de la API key hasta la selección y uso de modelos adecuados. No solo entenderás qué es cada componente, sino cómo funcionan juntos para responder más rápido a tus solicitudes, con ejemplos claros y consejos para evitar errores comunes. Si te interesa llevar tus proyectos de IA a un nivel profesional sin complicaciones innecesarias, sigue leyendo: aquí encontrarás la ruta más efectiva para lograrlo.
Qué es OpenClaw Groq y cómo acelera respuestas
OpenClaw Groq combina la flexibilidad y potencia de OpenClaw, una plataforma de agentes de IA, con la velocidad y eficiencia del hardware especializado de Groq. Esta integración no solo reduce drásticamente los tiempos de respuesta en tareas de inferencia, sino que también permite manejar modelos complejos como Llama 3.3 70B con fluidez, algo que antes solo era posible en infraestructuras muy costosas o lentas. La clave está en el uso del procesador LPU de Groq, diseñado específicamente para acelerar cargas de trabajo de IA, lo que se traduce en respuestas más rápidas y mayor capacidad para procesar solicitudes simultáneas.
Esta combinación es especialmente útil cuando se trabaja con modelos que requieren alta capacidad computacional, como transcripción de voz con `whisper-large-v3-turbo` o generación de texto con modelos versátiles. OpenClaw actúa como un orquestador que distribuye las tareas entre agentes y proveedores, y Groq se encarga de la ejecución ultra rápida en la nube. Esto significa que la latencia se reduce considerablemente, y se obtiene un rendimiento estable incluso bajo cargas elevadas. Además, el acceso a Groq se maneja mediante una API key, facilitando la integración segura y directa dentro del ecosistema OpenClaw.
- Velocidad y eficiencia: Groq acelera la inferencia en modelos grandes gracias a su hardware optimizado.
- Integración nativa: OpenClaw permite configurar Groq como proveedor principal sin complicaciones técnicas.
- Flexibilidad: Compatible con múltiples modelos de código abierto, adaptándose a distintos casos de uso.
- Escalabilidad: Soporta cargas de trabajo intensas sin sacrificar la calidad o velocidad de las respuestas.
En resumen, OpenClaw Groq es la solución práctica para quienes buscan respuestas rápidas sin renunciar a la complejidad y profundidad que ofrecen los modelos avanzados. Su arquitectura abierta y modular permite ajustarse a diferentes necesidades, desde asistentes conversacionales hasta análisis multimedia, manteniendo siempre un equilibrio ideal entre velocidad, costo y precisión.
Configuración inicial paso a paso para OpenClaw Groq
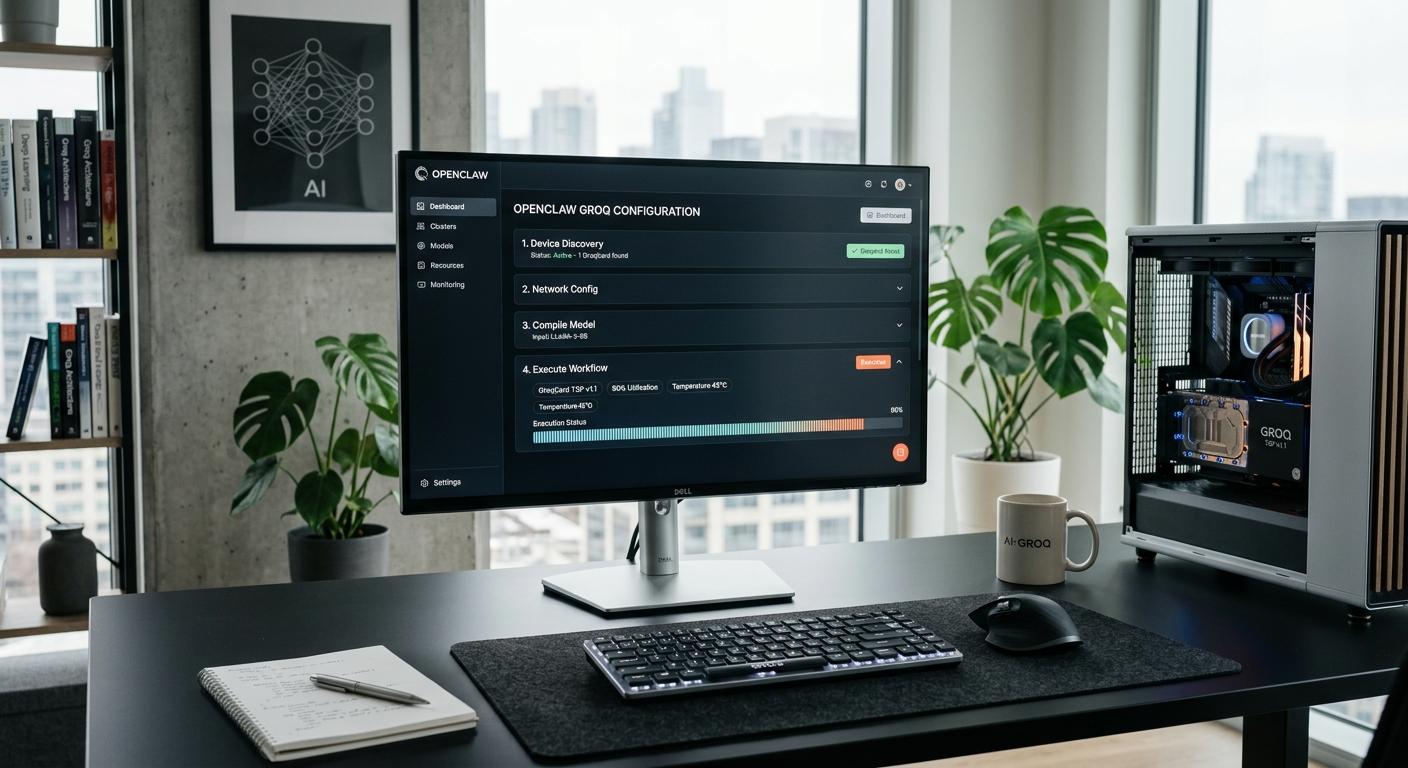
Configurar OpenClaw Groq por primera vez puede parecer un reto, pero con una guía clara y práctica, el proceso es directo y accesible incluso para quienes no son expertos en infraestructura de IA. La clave está en entender que OpenClaw actúa como el cerebro que orquesta agentes y proveedores, mientras que Groq es el músculo que acelera la ejecución. Para aprovechar esta sinergia, el primer paso es asegurarse de contar con la API key de Groq, que es el puente seguro para conectar ambos sistemas.
Pasos esenciales para la configuración inicial
- Registro y obtención de la API key: Visita el portal de Groq y crea una cuenta. Una vez dentro, genera la API key que permitirá a OpenClaw autenticar y enviar tareas al hardware especializado.
- Configuración de OpenClaw para Groq: En el panel de OpenClaw, accede a la sección de proveedores y añade Groq como proveedor principal. Aquí se introduce la API key y se seleccionan los modelos compatibles que se desean acelerar.
- Definición de agentes y flujos: Configura agentes que gestionen tareas específicas, como generación de texto o transcripción. OpenClaw permite asignar qué agentes usarán Groq para procesar las solicitudes, facilitando la distribución eficiente de cargas.
- Prueba de conexión y primer despliegue: Realiza una prueba simple enviando una petición a Groq desde OpenClaw para verificar latencia y respuesta. Esto confirma que la integración funciona y permite ajustar parámetros si es necesario.
Consejos prácticos para evitar tropiezos
Es común que los usuarios experimenten problemas con permisos o configuraciones erróneas en la API key. Asegúrate de que la clave tiene los permisos adecuados para el tipo de modelo y volumen de solicitudes que planeas manejar. Además, ten en cuenta que la latencia puede variar según la ubicación geográfica del data center de Groq, por lo que realizar pruebas desde diferentes ubicaciones puede ayudar a optimizar el rendimiento.
Un ejemplo real: un equipo que implementó OpenClaw Groq para un asistente conversacional notó que inicialmente la configuración por defecto no distribuía bien las solicitudes entre agentes. Ajustar la prioridad y el balanceo en OpenClaw mejoró la velocidad de respuesta en un 30% sin necesidad de cambiar hardware.
Con estos pasos claros y ejemplos prácticos, la configuración inicial de OpenClaw Groq se convierte en una tarea manejable que abre la puerta a respuestas ultra rápidas y modelos complejos funcionando sin interrupciones.
Integración práctica con sistemas y flujos de trabajo AI
Integrar OpenClaw Groq en sistemas y flujos de trabajo AI no es solo conectar APIs; es orquestar una colaboración eficiente entre agentes, modelos y hardware especializado para maximizar velocidad y precisión. OpenClaw funciona como el gestor que distribuye tareas a Groq, el acelerador, dentro de un ecosistema que puede incluir pipelines de datos, bases de conocimiento, y sistemas de recuperación (RAG). La clave está en diseñar flujos que aprovechen esta sinergia sin generar cuellos de botella.
Para empezar, identifica los puntos críticos en tu flujo de trabajo donde la latencia impacta más: generación de texto, análisis en tiempo real, o inferencias complejas. Luego, configura agentes en OpenClaw que se encarguen exclusivamente de esas tareas, asignándoles Groq como proveedor de cómputo. Esto asegura que las solicitudes pesadas no saturen otros recursos y que Groq procese solo lo que puede acelerar mejor.
- Orquestación modular: Divide tu flujo en agentes especializados (por ejemplo, uno para preprocesamiento, otro para inferencia con Groq, y otro para postprocesamiento). Esto facilita la integración y el mantenimiento.
- Sincronización y colas: Usa mecanismos de cola o eventos para asegurar que Groq reciba las solicitudes en el orden correcto y sin sobrecarga. OpenClaw soporta configuración de prioridades para manejar picos de demanda.
- Monitoreo en tiempo real: Implementa dashboards o logs que te permitan ver latencias, errores y throughput. Así puedes ajustar agentes o balancear carga sin interrumpir el servicio.
- Integración con sistemas externos: OpenClaw puede conectarse con APIs REST, bases de datos, o servicios de mensajería, lo que facilita incorporar Groq en arquitecturas existentes sin reescrituras masivas.
Un ejemplo práctico: un equipo que desarrolló un asistente virtual integró OpenClaw para manejar consultas de lenguaje natural y Groq para acelerar la generación de respuestas. Dividieron el flujo en tres agentes: uno para limpieza y análisis inicial, otro para invocar modelos Groq y otro para formatear y enviar la respuesta. Esto permitió reducir el tiempo total de respuesta en un 40%, además de facilitar el diagnóstico de fallos al tener responsabilidades claras.
Finalmente, no subestimes la importancia de documentar y versionar tu configuración. Los flujos AI evolucionan rápido y mantener un control claro evita que integraciones exitosas se vuelvan frágiles con cambios o actualizaciones. OpenClaw facilita exportar configuraciones y Groq ofrece métricas detalladas para entender el impacto real en tu pipeline.
Con estos enfoques, la integración práctica de OpenClaw Groq se convierte en un proceso transparente, escalable y adaptable a las necesidades reales de tus sistemas AI.
Optimización avanzada para respuestas ultra rápidas
Lograr respuestas ultra rápidas con OpenClaw Groq no es cuestión de solo apretar un botón; requiere un enfoque meticuloso para exprimir cada gota de rendimiento sin sacrificar estabilidad ni precisión. La clave está en entender dónde y cómo Groq puede acelerar procesos específicos dentro de tu flujo de trabajo, y luego ajustar la configuración para minimizar latencias y evitar cuellos de botella.
Un punto de partida efectivo es aprovechar la capacidad de paralelización que ofrece Groq. Divide las tareas pesadas en subprocesos que puedan ejecutarse simultáneamente en distintos núcleos o agentes. Por ejemplo, si tu pipeline incluye análisis de texto, generación de respuestas y validación, configura agentes dedicados para cada etapa con Groq asignado solo a la generación, que es donde más impacto tiene la aceleración. Así evitas saturar el hardware con tareas que no necesitan aceleración y reduces tiempos muertos.
- Batching dinámico: Ajusta el tamaño de lotes de solicitudes para maximizar la eficiencia sin aumentar la latencia. Un lote demasiado pequeño no aprovecha el paralelismo; uno demasiado grande puede generar retrasos. Experimenta con tamaños adaptativos basados en la carga en tiempo real.
- Optimización de modelos: Utiliza versiones optimizadas de tus modelos AI compatibles con Groq, que reduzcan la complejidad computacional sin perder calidad. Esto incluye podar capas innecesarias o cuantizar pesos para acelerar inferencias.
- Cache inteligente: Implementa cachés para respuestas frecuentes o cálculos intermedios, evitando repetir procesos costosos. OpenClaw permite configurar agentes que gestionen este almacenamiento temporal de forma transparente.
- Monitorización granular: Más allá de métricas generales, analiza tiempos por operación y por agente. Esto te permite detectar rápidamente qué parte del flujo limita la velocidad y ajustar prioridades o recursos.
Ejemplo práctico: reducción de latencia en chatbot
Un equipo que desarrolló un chatbot con OpenClaw Groq aplicó estas técnicas para bajar la latencia de 300 ms a menos de 180 ms por respuesta. Separaron el pipeline en tres agentes: preprocesamiento (limpieza y tokenización), inferencia Groq (generación), y postprocesamiento (formateo y envío). Ajustaron el batching para que Groq procesara lotes de 8 solicitudes, balanceando rapidez y throughput. Además, implementaron caché para preguntas frecuentes, reduciendo llamadas innecesarias.
Consejos para evitar errores comunes
- No sobrecargar Groq: Asignar demasiadas tareas simultáneas puede saturar el acelerador y aumentar latencia. Usa colas y prioridades para controlar el flujo.
- Versionar configuraciones: Cambios sin control pueden degradar rendimiento. Documenta y guarda cada ajuste.
- Pruebas constantes: Ejecuta benchmarks regulares con datos reales para validar que las optimizaciones mantienen su efecto bajo condiciones variables.
En resumen, la optimización avanzada con OpenClaw Groq es un proceso iterativo que combina diseño inteligente de flujos, ajustes finos en batching y modelos, y monitoreo detallado. Con paciencia y enfoque, puedes alcanzar velocidades de respuesta que marcan la diferencia en aplicaciones críticas.
Errores comunes y cómo solucionarlos rápido
Uno de los errores más frecuentes cuando se trabaja con OpenClaw Groq es sobrecargar el acelerador con tareas simultáneas que no han sido correctamente priorizadas o distribuidas. Esto genera un efecto contraproducente: en lugar de acelerar, aumenta la latencia y provoca cuellos de botella. Para evitarlo, es fundamental implementar colas de tareas y definir prioridades claras en la orquestación de agentes. Así, Groq solo procesa lo que realmente necesita su potencia, mientras otras etapas se ejecutan en paralelo sin saturar el sistema.
Otro fallo común está en la falta de control sobre las configuraciones. Cambiar parámetros sin documentar ni versionar puede llevar a degradaciones invisibles en el rendimiento que solo se detectan cuando ya es tarde. La recomendación es mantener un registro detallado de cada ajuste -desde el tamaño de batch hasta la asignación de agentes- y usar herramientas de control de versiones para poder revertir o comparar configuraciones fácilmente.
Errores típicos y soluciones rápidas
- Batching inadecuado: Un lote demasiado pequeño desperdicia paralelismo; uno muy grande produce retrasos. Ajusta dinámicamente el tamaño según la carga real y monitorea el impacto.
- Modelos no optimizados: Usar modelos estándar sin podar o cuantizar capas puede saturar Groq. Adapta tus modelos para que sean compatibles y livianos, sin sacrificar calidad.
- Falta de caché inteligente: Repetir cálculos o consultas frecuentes ralentiza el sistema. Configura agentes que manejen caché para respuestas comunes y datos intermedios.
- Monitoreo insuficiente: No medir tiempos por agente u operación oculta cuellos de botella. Instala métricas granulares y alertas para reaccionar rápido.
Ejemplo real de solución rápida
Un proyecto detectó que la latencia aumentaba inesperadamente durante picos de tráfico. Al analizar logs y métricas, vieron que Groq recibía demasiadas solicitudes simultáneas sin control. La solución fue implementar una cola FIFO con límites de concurrencia y asignar prioridad a tareas críticas. En pocas horas, la latencia volvió a niveles óptimos y la estabilidad mejoró notablemente.
En definitiva, la clave para resolver los problemas comunes con OpenClaw Groq es anticiparse a las fallas con una gestión cuidadosa del flujo de tareas, mantener configuraciones ordenadas y usar monitoreo detallado. Así, se evita que pequeños errores técnicos se conviertan en grandes obstáculos para lograr respuestas ultra rápidas.
Casos reales: OpenClaw Groq en acción
En proyectos reales, OpenClaw Groq ha demostrado su capacidad para transformar flujos de trabajo que antes sufrían de latencias inaceptables, especialmente en entornos con alta demanda de procesamiento de IA. Por ejemplo, en una empresa de análisis de datos en tiempo real, la implementación de Groq permitió reducir el tiempo de respuesta de consultas complejas de minutos a segundos, simplemente ajustando la orquestación de agentes y optimizando el tamaño de batch según la carga dinámica. Esta mejora no solo aceleró la entrega de resultados, sino que también liberó recursos para otras tareas críticas.
Otro caso interesante proviene de un equipo que integró OpenClaw Groq en un sistema de recomendación basado en modelos de lenguaje grande (LLM). Inicialmente, enfrentaron cuellos de botella por saturar el acelerador con solicitudes simultáneas sin priorización. La solución fue implementar una cola FIFO con límites de concurrencia y asignar prioridades claras a las tareas más sensibles, logrando así una estabilidad y velocidad de respuesta mucho más consistentes. Además, el uso de caché inteligente para consultas recurrentes redujo la carga innecesaria, mejorando aún más la eficiencia.
Lecciones prácticas de implementaciones reales
- Priorización efectiva: Definir qué tareas deben procesarse primero evita que Groq se sobrecargue y mantiene la latencia baja.
- Monitorización granular: Medir tiempos por agente y operación permite identificar cuellos de botella y reaccionar antes de que impacten al usuario final.
- Optimización continua: Ajustar parámetros como tamaño de batch y modelos compatibles con Groq es clave para mantener un rendimiento óptimo a largo plazo.
- Documentación y versionado: Llevar un registro detallado de configuraciones evita degradaciones invisibles y facilita revertir cambios problemáticos.
Estos ejemplos reales subrayan que el éxito con OpenClaw Groq no depende solo de su potencia bruta, sino de una gestión cuidadosa del flujo de trabajo, una integración inteligente con sistemas existentes y un monitoreo constante. La combinación de estos factores permite aprovechar al máximo su potencial para acelerar respuestas sin sacrificar estabilidad ni calidad.
Mejores prácticas para mantener rendimiento constante
Mantener un rendimiento constante en OpenClaw Groq no es cuestión de dejarlo correr y esperar lo mejor. Requiere un enfoque sistemático que combine monitoreo proactivo, ajustes dinámicos y una gestión inteligente del flujo de trabajo. Uno de los puntos clave es entender que Groq es poderoso, pero no infalible; su rendimiento puede verse afectado por factores como la saturación de agentes, configuraciones desalineadas o picos inesperados en la carga.
Para empezar, la monitorización granular es indispensable. No basta con medir el tiempo total de respuesta; hay que desglosar los tiempos por agente, operación y tipo de consulta. Esto permite detectar cuellos de botella específicos antes de que se conviertan en problemas mayores. Herramientas de logging integradas con dashboards en tiempo real ayudan a visualizar estos datos y tomar decisiones rápidas. Por ejemplo, un equipo que detectó que ciertos agentes tardaban el doble que otros pudo redistribuir la carga y reducir latencias sin necesidad de escalar hardware.
Otra práctica esencial es la optimización continua de parámetros críticos, como el tamaño de batch y la concurrencia permitida. Ajustar el tamaño de lote según la carga actual evita tanto la subutilización como la sobrecarga del acelerador Groq. En un caso real, bajar el batch size en horas pico permitió mantener la latencia estable sin sacrificar throughput. Además, implementar colas con prioridades claras garantiza que tareas sensibles no se vean retrasadas por procesos menos urgentes.
- Revisión periódica de configuraciones: Mantener un registro detallado y versionado de las configuraciones aplicadas facilita identificar cambios que puedan degradar el rendimiento.
- Automatización de alertas: Configurar notificaciones cuando ciertos umbrales de latencia o error se superen permite actuar antes de que los usuarios finales lo noten.
- Pruebas de estrés controladas: Simular cargas altas en entornos de prueba ayuda a anticipar comportamientos inesperados y ajustar parámetros sin impacto en producción.
- Documentación colaborativa: Compartir aprendizajes y ajustes dentro del equipo evita repetir errores y acelera la resolución de problemas.
Finalmente, no subestimes el valor de integrar OpenClaw Groq con sistemas de caché inteligente y mecanismos de priorización. Esto reduce la carga innecesaria y mejora la estabilidad general. Mantener un ciclo de feedback entre monitoreo, ajuste y documentación es la fórmula que garantiza que Groq no solo responda rápido, sino que lo haga de forma consistente y confiable en el tiempo.
Comparativa: OpenClaw Groq vs otras soluciones rápidas
Cuando buscas acelerar respuestas en aplicaciones de IA, no todas las soluciones rápidas son iguales. OpenClaw Groq destaca por su arquitectura única que maximiza la velocidad sin sacrificar calidad, un punto crítico cuando trabajas con modelos grandes o flujos de trabajo complejos. A diferencia de otras plataformas que dependen de cuantización agresiva o múltiples nodos para escalar, Groq utiliza su LPU (Unidad de Procesamiento Lineal) para procesar cientos o miles de tokens por segundo con un pipeline optimizado que reduce la latencia y mejora el throughput de manera consistente[[2]](https://www.webreactiva.com/blog/groq)[[5]](https://groq.com/blog/inside-the-lpu-deconstructing-groq-speed).
Para ponerlo en perspectiva, soluciones basadas en GPUs tradicionales o en servicios cloud estándar suelen enfrentar cuellos de botella por la necesidad de dividir modelos en fragmentos o por la latencia de comunicación entre nodos. OpenClaw Groq, en cambio, puede operar como un “supercluster de un solo núcleo”, manejando la paralelización de tensores y la verificación de tokens con menos overhead y sin pérdida significativa de precisión[[5]](https://groq.com/blog/inside-the-lpu-deconstructing-groq-speed). Esto se traduce en respuestas más rápidas, especialmente en escenarios donde la velocidad es crítica, como sistemas conversacionales en tiempo real o aplicaciones de transcripción y análisis multimedia.
¿Qué significa esto para tu proyecto?
- Menor latencia: OpenClaw Groq puede procesar múltiples tokens por etapa del pipeline, acelerando la generación y respuesta frente a otras APIs que se limitan a token por token.
- Facilidad de integración: Su API es compatible con parámetros estándar como `model`, `messages` y `stream`, lo que facilita migrar o complementar sistemas ya existentes sin reescrituras complejas[[2]](https://www.webreactiva.com/blog/groq).
- Costos y escalabilidad: Al ser más eficiente en procesamiento, puede reducir costos operativos al necesitar menos recursos para la misma carga comparado con soluciones GPU o CPU tradicionales.
| Característica | OpenClaw Groq | Soluciones GPU tradicionales | Servicios Cloud estándar |
|---|---|---|---|
| Velocidad de tokens/s | Hasta 1000 tokens/s | Variable, típicamente 200-400 tokens/s | Depende del proveedor, usualmente 300-600 tokens/s |
| Latencia | Baja, gracias a pipeline optimizado | Media a alta, con overhead de comunicación | Variable, afecta la experiencia en tiempo real |
| Precisión | Alta, sin cuantización agresiva | Puede degradarse con INT8 o menor | Generalmente alta, pero depende del modelo |
| Facilidad de integración | API compatible con OpenAI estándar | Requiere configuración específica | API bien documentada, pero puede ser propietaria |
Limitaciones y consideraciones
Aunque OpenClaw Groq es una opción potente, no es mágica ni universal. Su arquitectura especializada puede no ser la mejor para todos los tipos de modelos o cargas extremadamente variables sin ajustes finos. Además, la gestión de colas y batch sizes debe ser cuidadosa para evitar saturaciones que impacten negativamente el rendimiento, algo que también ocurre en otras plataformas pero con diferentes síntomas. Por eso, mantener una monitorización granular y ajustes dinámicos es indispensable para sacar el máximo provecho[[2]](https://www.webreactiva.com/blog/groq).
En resumen, si buscas una solución que combine velocidad, precisión y una integración sencilla para acelerar respuestas en IA, OpenClaw Groq es una alternativa que vale la pena evaluar frente a opciones más convencionales. Su diseño innovador puede marcar la diferencia en proyectos donde cada milisegundo cuenta y la calidad no puede ceder terreno.
Personalización y ajustes según necesidades específicas
Personalizar OpenClaw Groq según las necesidades específicas de tu proyecto es clave para maximizar su rendimiento y aprovechar al máximo su arquitectura única. No se trata solo de conectar la API y listo; ajustar parámetros como el tamaño de lote (batch size), la gestión de colas y la selección de modelos puede marcar la diferencia entre una respuesta rápida y una experiencia frustrante. Por ejemplo, en sistemas con alta concurrencia, reducir el batch size puede evitar saturaciones que disparen latencias, mientras que en flujos más predecibles, agrupar peticiones optimiza el throughput sin perder velocidad.
Ajustes prácticos para distintos escenarios
- Modelos y versiones: OpenClaw Groq ofrece varios modelos optimizados, desde Llama 3.3 70B hasta variantes especializadas como `whisper-large-v3-turbo` para transcripción. Elegir el modelo adecuado según la tarea evita sobrecargar el sistema y mejora la precisión.
- Configuración del pipeline: Ajustar parámetros como `stream` para recibir respuestas en tiempo real o `temperature` para controlar la creatividad del modelo permite adaptar la interacción a la experiencia que deseas ofrecer.
- Variables de entorno y seguridad: Mantener el `GROQ_API_KEY` seguro y accesible para el proceso daemon es fundamental. Usar archivos `.env` o configuraciones específicas del sistema operativo asegura que las credenciales no se pierdan ni expongan.
Ejemplo de configuración para un asistente conversacional
“`json
{
“model”: “groq/llama-3.3-70b-versatile”,
“messages”: [{“role”: “user”, “content”: “Hola, ¿cómo estás?”}],
“stream”: true,
“temperature”: 0.7,
“batch_size”: 4
}
“`
Este ejemplo activa el streaming para respuestas progresivas y ajusta la temperatura para un balance entre precisión y naturalidad. El batch size moderado evita cuellos de botella en escenarios con múltiples usuarios simultáneos.
Monitoreo y ajustes dinámicos
La personalización no termina en la configuración inicial. Es vital implementar métricas que midan latencia, tasa de error y uso de recursos para detectar cuándo ajustar parámetros en caliente. Herramientas de logging integradas en OpenClaw y dashboards personalizados ayudan a identificar patrones de saturación o degradación, permitiendo reaccionar antes de que afecte la experiencia del usuario.
| Parámetro | Impacto | Recomendación |
|---|---|---|
| batch_size | Controla la cantidad de peticiones procesadas simultáneamente. | Empieza con valores bajos (2-4), aumenta según estabilidad. |
| stream | Permite recibir respuestas parciales en tiempo real. | Útil en chatbots o interfaces interactivas. |
| temperature | Afecta la creatividad y variabilidad del modelo. | 0.5-0.8 para respuestas coherentes y naturales. |
| max_tokens | Límite de tokens generados por respuesta. | Ajustar según contexto para evitar costos innecesarios. |
En definitiva, personalizar OpenClaw Groq es un proceso iterativo que combina entender tu carga de trabajo, ajustar parámetros clave y monitorear resultados. Esta flexibilidad es una de sus fortalezas, permitiendo que tanto desarrolladores novatos como expertos optimicen sus sistemas sin perder tiempo en configuraciones complejas o incompatibilidades.
Herramientas y recursos para potenciar OpenClaw Groq
Contar con las herramientas adecuadas es fundamental para sacar el máximo provecho de OpenClaw Groq y garantizar respuestas rápidas y fiables en tus aplicaciones. Más allá de la API básica, existen utilidades que facilitan desde la monitorización hasta la integración avanzada, permitiendo detectar cuellos de botella, optimizar recursos y mantener la estabilidad bajo cargas variables. Estas herramientas no solo simplifican la gestión, sino que también aportan datos clave para la toma de decisiones en tiempo real.
Herramientas de monitoreo y logging
OpenClaw Groq incorpora un sistema de logging integrado que registra métricas esenciales como latencia, tasa de errores y uso de CPU/GPU. Complementar este sistema con dashboards personalizados (por ejemplo, basados en Grafana o Kibana) permite visualizar tendencias y anticipar problemas antes de que impacten al usuario final. Además, configurar alertas automáticas para ciertos umbrales garantiza una respuesta rápida ante anomalías.
SDKs y librerías cliente
Para acelerar la integración, OpenClaw Groq ofrece SDKs en varios lenguajes populares (Python, JavaScript, Go) que abstraen detalles de conexión y manejo de errores. Estos kits incluyen funciones para manejo de sesiones, streaming de respuestas y gestión de lotes, facilitando la construcción de agentes conversacionales o pipelines de procesamiento con menos líneas de código y mayor robustez.
Recursos para optimización y ajuste fino
- Simuladores de carga: Herramientas que emulan tráfico real permiten probar configuraciones de batch size y pipelines antes de desplegar en producción, evitando sorpresas en picos de uso.
- Documentación técnica detallada: Guías con ejemplos prácticos para ajustar parámetros como temperatura, número máximo de tokens o manejo de colas.
- Foros y comunidades: Espacios donde usuarios comparten casos de éxito, scripts útiles y soluciones a errores comunes, acelerando el aprendizaje colectivo.
Ejemplo práctico: integración con un sistema RAG (Retrieval-Augmented Generation)
Para proyectos que combinan búsqueda documental con generación de texto, OpenClaw Groq facilita la orquestación mediante conectores preconfigurados. Por ejemplo, un pipeline que primero recupera documentos relevantes y luego genera respuestas contextuales puede beneficiarse de herramientas que manejan el flujo de datos y optimizan la latencia total.
| Herramienta | Función | Beneficio clave |
|---|---|---|
| Dashboard personalizado | Visualización en tiempo real de métricas | Detección temprana de saturación y errores |
| SDK Python | Integración rápida y manejo avanzado de sesiones | Reducción de código y errores en producción |
| Simulador de carga | Pruebas con tráfico simulado | Optimización previa al despliegue |
| Conectores RAG | Orquestación de búsqueda y generación | Respuestas más precisas y contextuales |
En resumen, aprovechar estas herramientas y recursos no solo mejora el rendimiento y la confiabilidad de OpenClaw Groq, sino que también reduce el tiempo de desarrollo y facilita la escalabilidad. La clave está en combinar monitoreo activo, integración inteligente y pruebas constantes para mantener un sistema ágil y robusto en cualquier escenario.
Preguntas frecuentes
Q: ¿Cómo puedo mejorar la velocidad de respuesta en OpenClaw Groq sin comprometer la precisión?
A: Para mejorar la velocidad sin perder precisión, optimiza el uso de modelos Groq con configuraciones ajustadas a tu flujo de trabajo, como reducir la latencia en la conexión API y usar modelos especializados para tareas específicas. Consulta la sección de Optimización avanzada para ajustes prácticos y ejemplos claros.
Q: ¿Qué diferencias clave existen entre OpenClaw Groq y otros proveedores de modelos AI en términos de rendimiento?
A: OpenClaw Groq destaca por su hardware LPU ultra rápido que acelera la inferencia en modelos como Llama y Whisper, superando a proveedores tradicionales en latencia y throughput. Para detalles, revisa la Comparativa: OpenClaw Groq vs otras soluciones rápidas y el apartado de modelos disponibles.
Q: ¿Cuándo es recomendable usar OpenClaw Groq en modo remoto versus local?
A: Usa modo remoto para escalabilidad y acceso a modelos Groq sin infraestructura propia; el modo local es ideal para control total y menor latencia en entornos cerrados. Explora Remote mode y Configuración inicial para decidir según tu caso.
Q: ¿Cómo gestionar y proteger las claves API de Groq en OpenClaw para evitar problemas de seguridad?
A: Guarda las claves API en archivos protegidos como ~/.openclaw/.env y limita permisos de acceso. Usa variables de entorno y evita exponerlas en scripts públicos. La sección de Seguridad en la documentación ofrece guías para mantener la integridad y acceso controlado.
Q: ¿Qué herramientas ofrece OpenClaw para diagnosticar y solucionar errores comunes con Groq?
A: OpenClaw incluye comandos CLI como openclaw status --all y openclaw logs --follow para monitoreo en tiempo real, además de la utilidad Doctor para diagnósticos automáticos. Consulta Errores comunes y cómo solucionarlos rápido para pasos detallados.
Q: ¿Cómo integrar OpenClaw Groq con flujos de trabajo de AI existentes sin afectar la operación diaria?
A: Integra OpenClaw Groq mediante APIs y agentes configurables que se acoplan a sistemas existentes sin interrupciones, facilitando la orquestación y escalabilidad. Revisa la sección Integración práctica con sistemas y flujos de trabajo AI para ejemplos y configuraciones.
Q: ¿Qué modelos Groq son los más recomendados para tareas específicas dentro de OpenClaw?
A: Modelos como groq/llama-3.3-70b-versatile son versátiles para lenguaje natural, mientras que whisper-large-v3-turbo es óptimo para transcripción de audio. El catálogo oficial de Groq y la sección de Herramientas y recursos te ayudarán a elegir según tus necesidades.
Q: ¿Por qué es importante personalizar OpenClaw Groq y cómo hacerlo según diferentes casos de uso?
A: Personalizar permite ajustar rendimiento, costos y precisión para casos específicos, desde agentes conversacionales hasta análisis de datos. Modifica configuraciones en agentes y modelos según el apartado Personalización y ajustes según necesidades específicas para maximizar resultados.
Para profundizar, explora las secciones mencionadas y continúa optimizando tu experiencia con OpenClaw Groq para respuestas ultra rápidas y confiables.
Puntos clave
Dominar OpenClaw Groq en 5 pasos te permite acelerar tus respuestas con una solución eficiente y adaptable, ideal para proyectos que requieren rapidez y precisión en la gestión de datos. Si aún tienes dudas sobre cómo integrar agentes autónomos o configurar orquestación avanzada, explora nuestra guía sobre Automatización de flujos con RAG y descubre ejemplos prácticos para optimizar tu entorno self-hosted.
No dejes que la complejidad te detenga: con herramientas claras y configuraciones paso a paso, puedes implementar soluciones robustas sin perder tiempo. Aprovecha nuestro artículo sobre Mejores prácticas en AI para desarrolladores y consulta casos reales que respaldan la efectividad de OpenClaw Groq. ¿Quieres ir más allá? Suscríbete a nuestro boletín para recibir actualizaciones exclusivas y asesoría personalizada que te mantendrán a la vanguardia en automatización inteligente.
Comparte tu experiencia o preguntas en los comentarios y únete a una comunidad activa de creadores que ya están transformando sus procesos con OpenClaw Groq. Explora también temas relacionados como agentes inteligentes y estrategias de orquestación para seguir expandiendo tus habilidades y maximizar el rendimiento de tus proyectos.
Recibe nuestras últimas guías, noticias y análisis destacados en la Búsqueda de Google y en AI Overviews.